Hay una forma muy cómoda de ganar una discusión cuando te has quedado sin argumentos. Basta con decirle al otro que es un caso de manual del efecto Dunning–Kruger. Entiende tan poco del asunto que ni siquiera se da cuenta de su propia incompetencia. Cuanto más seguro se muestra al replicar, más evidente parece el diagnóstico. Y cualquier intento de defenderse puede despacharse como otro síntoma.
La etiqueta suena científica. La investigación que hay detrás, en cambio, cuenta una historia bastante más complicada. Los psicólogos observaron que quienes obtenían peores resultados en determinadas pruebas tendían a sobrevalorar su posición respecto a los demás más que quienes rendían mejor. Propusieron una explicación psicológica y encontraron pruebas experimentales a su favor. Más tarde se vio que un patrón parecido podía aparecer por otras razones, entre ellas la propia forma de medir.
Lo que esos estudios no permiten es determinar cuánto entiende alguien de un tema a partir de la seguridad con la que discute.
En agosto de 2026 se debatía en Hacker News una propuesta biotecnológica bastante radical. Un comentarista respondió que el nombre de su autor debería aparecer en el diccionario junto al efecto Dunning–Kruger [1]. No analizó la propuesta ni dio un solo argumento en contra. Por lo visto, bastaban dos apellidos.
¿De dónde salió la gráfica del «monte de la estupidez»?
Seguro que has visto el dibujo. Alguien que apenas conoce un tema se encarama a toda velocidad a la cima de la confianza en sí mismo: el «monte de la estupidez» (Mount Stupid). Después viene el «valle de la desesperación» y, por último, la larga subida por la «pendiente de la iluminación».
Una gráfica muy práctica. Casi cualquier persona que te irrite en una discusión encuentra allí su sitio, preferiblemente cerca de la cumbre.
El problema es que esa imagen no aparece en el trabajo de Justin Kruger y David Dunning de 1999 [2]. No estudiaron cómo cambia la confianza de una misma persona conforme aprende. Lo que hicieron fue poner a prueba el sentido del humor, la gramática y la lógica de distintas personas, y luego pedirles que valoraran sus capacidades frente a las de los demás participantes.
En el primer experimento, los participantes del cuartil inferior se situaban aproximadamente en el percentil 12, pero se colocaban a sí mismos cerca del 58. El percentil indica la posición dentro de un grupo: estar en el percentil 20 significa que alrededor del 20 % de los participantes obtuvo una puntuación inferior a la tuya.
Quienes obtenían mejores resultados también se atribuían más capacidad, pero sus autoevaluaciones subían mucho más despacio que sus puntuaciones reales. El estudio no encontró ningún pico inevitable de confianza excesiva entre principiantes.
Kruger y Dunning propusieron que realizar bien una tarea y detectar los propios errores dependen, en parte, de las mismas habilidades. Un ajedrecista principiante quizá no advierta un mate dentro de tres jugadas. Su seguridad no tiene por qué ser arrogancia: puede que sencillamente le falten conocimientos para advertir el peligro.
En uno de los experimentos, los psicólogos dieron a los participantes formación en razonamiento lógico. Después, sus autoevaluaciones se volvieron más precisas. Es una prueba relevante a favor del mecanismo propuesto. Sería injusto reducir todo el artículo de 1999 a una gráfica polémica.
Con el tiempo, otros investigadores empezaron a comprobar explicaciones más prosaicas de aquella curva, comenzando por los propios instrumentos de medida.
Saberse la lección no es lo mismo que comprenderla
Pero detrás de la discusión sobre las gráficas hay una pregunta más amplia. Ni siquiera con los resultados de las pruebas y las autoevaluaciones de los participantes pueden los investigadores determinar siempre por qué se equivocan. Y, sin embargo, a veces estamos dispuestos a juzgar la competencia de un desconocido a partir de un único comentario rotundo en internet.
Una cosa es conocer una materia y otra saber dónde terminan tus conocimientos.
Hay una regla escolar muy conocida: no se puede calcular la raíz cuadrada de un número negativo.
Un alumno se la aprende, aprueba el examen con sobresaliente y ya está listo para explicársela a todo el mundo. Pero imaginemos que un profesor de matemáticas le dice que la ecuación x² = −1 sí tiene soluciones. El alumno quizá se indigne. ¡Eso no es lo que le enseñaron!
La cuestión es que ambos tienen razón, siempre que hablen de sistemas numéricos distintos. Entre los números reales no existe ninguna solución. Entre los complejos hay dos: i y −i, donde i² = −1.
El profesor sabe que la regla escolar es válida para los números reales. Si ampliamos el sistema numérico, aparecen soluciones que no existían dentro del anterior.
El alumno puede recordar la regla a la perfección sin entender que pertenece a un marco matemático concreto. Y así, de un dato correcto acaba saliendo una conclusión falsa.
Por cierto, este ejemplo encaja bastante bien con la hipótesis original de Kruger y Dunning. A una persona pueden faltarle conocimientos tanto para resolver bien un problema como para reconocer su propio error. Es la «doble carga» de la incompetencia. Y no se queda en el aula: también un especialista puede salirse de los límites de su formación sin advertirlo. Por eso, poner la etiqueta no explica nada. Todavía hay que mostrar dónde falla exactamente el razonamiento.
Es una distinción a la que vuelvo una y otra vez cuando se discute sobre los expertos. Alguien estudia una disciplina, aprende sus definiciones, aprueba exámenes, obtiene un título y cumple los requisitos para ejercer. Según los criterios establecidos, es competente. Pero ¿hasta qué punto sabe cuestionar esos criterios, detectar supuestos ocultos y mirar más allá del modelo que domina?
La cualificación profesional es una razón para confiar en un especialista: refleja formación, práctica y requisitos de acreditación. No demuestra que cada una de sus conclusiones sea correcta. Un médico puede equivocarse al diagnosticar, un matemático puede pasar por alto una premisa falsa y un investigador puede atribuir a sus propios datos más fuerza de la que tienen.
Lo que sostiene una afirmación son las pruebas, no la biografía de quien la hace.
El esquema siguiente distingue entre conocer una materia y ser capaz de revisar un razonamiento por cuenta propia.
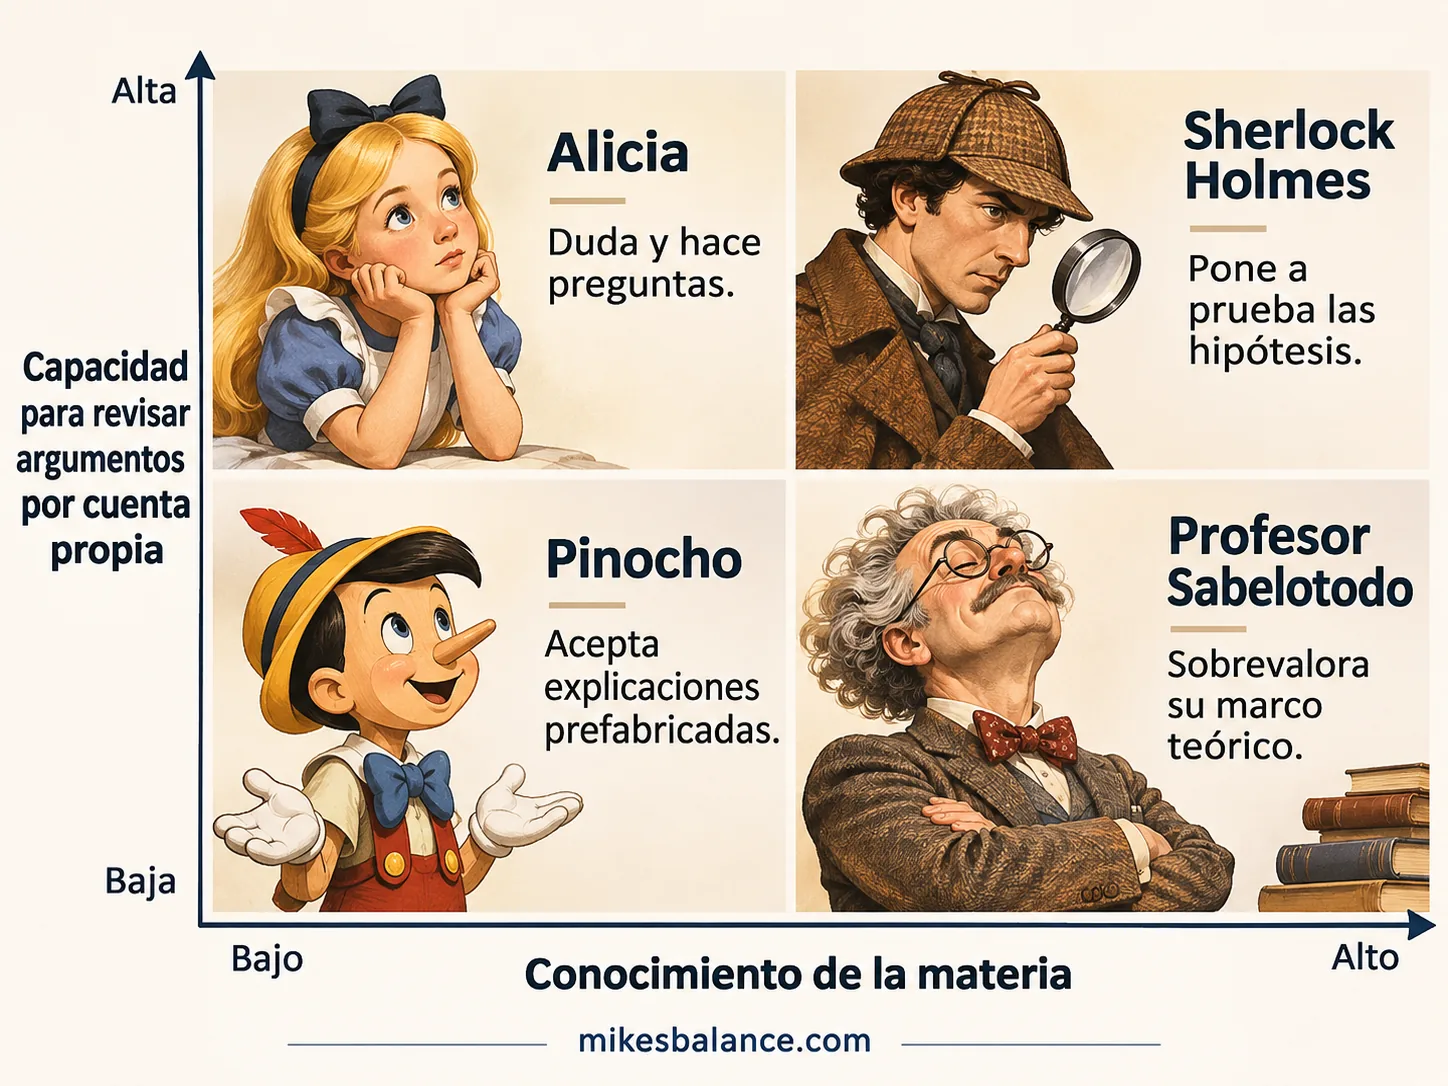
En la práctica hacen falta las dos habilidades. El conocimiento evita que tengamos que redescubrir lo que otros ya han comprobado. El razonamiento independiente ayuda a detectar cuándo han cambiado las condiciones o cuándo una explicación conocida deja fuera algo importante.
Una objeción de alguien sin formación específica puede revelar el error de un experto. O puede venirse abajo al encontrarse con hechos establecidos hace mucho. Para distinguir una cosa de la otra hay que examinar la objeción en sí.
La confianza, por sí sola, no nos dirá quién entiende mejor el asunto. Un profesor de matemáticas puede tener la certeza absoluta de que existen los números complejos, y contar con excelentes motivos. Un alumno puede estar igual de seguro de lo contrario si cree que una regla escolar se aplica a toda la matemática.
Cómo la estadística puede hacernos parecer demasiado seguros
Imagina a dos personas igual de preparadas. Ambas aciertan, de media, el 70 % de las preguntas. Una tiene mala suerte con las preguntas que le tocan y obtiene un 60 %; la otra tiene más suerte y llega al 80 %. Las dos estiman que su capacidad es del 70 %. ¿Cuál se ha sobrevalorado? En realidad, ninguna. Pero si comparamos sus estimaciones con los resultados de ese examen concreto, la primera parecerá «demasiado segura» por 10 puntos porcentuales y la segunda «demasiado modesta» por otros 10.
Ahora divide a la gente en grupos según la nota obtenida. En el grupo inferior habrá más personas que tuvieron mala suerte en esa prueba; en el superior, más que tuvieron buena suerte. Empieza a dibujarse la curva conocida: los peores resultados parecen acompañarse de sobreestimación y los mejores, de subestimación. Pero en nuestro ejemplo nadie juzgó mal su capacidad real.
También hay una trampa aritmética. Define el «error de autoevaluación» restando la nota del test a la autoevaluación, y después compara esa diferencia con la misma nota que acabas de restar. Si la autoevaluación permanece constante, cada 10 puntos adicionales en el test reducen automáticamente en 10 el «error» calculado. La misma nota aparece a ambos lados de la comparación.
Nada de esto convierte el efecto Dunning–Kruger en una invención total. Significa que la forma de una gráfica, por sí sola, no revela qué la ha causado. Joachim Krueger y Ross Mueller plantearon este problema [3]. Nuhfer y sus colegas [4], así como Gignac y Zajenkowski [5], investigaron el papel del ruido aleatorio y de la medición.
Una pequeña curiosidad: Justin Kruger, coautor del estudio de 1999, y Joachim Krueger, autor de la crítica de 2002, no son la misma persona. De lo contrario, podría parecer que Kruger había cambiado de opinión tres años después para refutarse a sí mismo.
Blair Fix obtuvo una curva parecida incluso utilizando variables aleatorias [6]. Pero su modelo parte del supuesto de que la autoevaluación no guarda relación con el rendimiento. Es una prueba matemática útil, no un modelo de cómo se comportan las personas reales, como señalaron sus críticos [7]. Mientras tanto, Jansen y sus colegas encontraron indicios de que quienes obtienen peores resultados son realmente menos sensibles a la información sobre sus propios errores [8].
La curva existe. Lo que hay que averiguar es qué parte de su forma se debe a la psicología y cuál a la manera de medir el rendimiento. Para eso hacen falta más datos, no conjeturas sobre la personalidad de los participantes.
Un mismo test, dos formas muy distintas de evaluarse
¿Qué significa «sobrevalorarse»? ¿Calcular mal cuántas respuestas has acertado o juzgar mal tu posición respecto a los demás? Parece lo mismo, pero son dos medidas distintas.
En un experimento de 2022 de McIntosh y sus colegas, los participantes resolvieron problemas de razonamiento con matrices. Después estimaron tanto cuántos habían contestado correctamente como su posición respecto a otros estudiantes [9]. En The Null Institute recalculamos de manera independiente los datos publicados de 151 participantes [10]. Estos son los resultados de las 38 personas del cuartil inferior en la prueba preliminar:
| Qué estimaron los participantes | Su estimación | Resultado real |
|---|---|---|
| Porcentaje de respuestas correctas | 76,0 % | 76,1 % |
| Posición respecto a los demás (percentil) | 51,2 | 19,8 |
La primera fila muestra una coincidencia casi exacta. En la segunda, la diferencia es de 31,4 puntos percentiles. De media, esas mismas personas calcularon bastante bien cuántas preguntas habían acertado, pero sobreestimaron mucho su posición frente a los demás.
Sin embargo, esa coincidencia casi perfecta solo se da en promedio. De las 38 personas, 22 sobreestimaron el número de aciertos, 14 lo subestimaron y dos acertaron exactamente. El error absoluto medio fue de 7,7 puntos porcentuales. Los errores en sentidos opuestos se compensaron parcialmente.
Esa comparación tiene un límite. Los participantes estimaron su posición entre los estudiantes de la Universidad de Edimburgo, mientras que nosotros calculamos su percentil real dentro de la muestra del estudio. Además, la escala de autoevaluación era poco habitual: el cero significaba un 50 % de respuestas correctas, el resultado esperable al responder al azar. El nuevo análisis tiene en cuenta esa escala, aunque no podemos saber cómo la interpretó cada participante [9], [10].
En la muestra completa, los participantes en realidad subestimaron sus puntuaciones en una media de 7,64 puntos porcentuales. Aun así, la asociación entre el rendimiento en la prueba preliminar y el error de autoevaluación siguió siendo negativa. En el cuartil superior, la nota media rondó el 97 %: apenas había margen para sobreestimarla, pero mucho para subestimarla.
Precisión y posición relativa no son intercambiables. Una persona puede estimar bastante bien su propia puntuación y equivocarse mucho respecto a su lugar entre los demás. La distinción entre autoevaluación absoluta y relativa se conoce desde hace tiempo [11]. Lo que hemos hecho es comprobar de forma independiente un conjunto de datos concreto, no descubrir un nuevo efecto psicológico. Las tablas detalladas, el método y el código están en la nota de investigación de The Null Institute.
Cuando los expertos cambian sus recomendaciones
Durante la pandemia de COVID-19 se hizo especialmente evidente la distancia entre saber algo, comprenderlo y decidir qué hacer.
La seguridad de las vacunas, los riesgos de infección y la utilidad de determinadas medidas exigían tipos de pruebas distintos. Sin embargo, las recomendaciones se trataban a menudo como respuestas definitivas que los no especialistas simplemente debían aceptar. Las preguntas podían atribuirse a la supuesta incompetencia de quien las hacía, en lugar de responderse por su contenido.
El caso de la vacuna de AstraZeneca muestra por qué ese enfoque puede fallar.
Tras el inicio de la vacunación masiva aparecieron informes sobre una combinación poco frecuente de coágulos sanguíneos y recuentos bajos de plaquetas. El 7 de abril de 2021, el Comité Conjunto de Vacunación e Inmunización del Reino Unido (JCVI) recomendó ofrecer una vacuna alternativa a los adultos menores de 30 años sin factores de riesgo adicionales, siempre que hubiera una disponible [12].
El cambio respondía a nuevos datos sobre un efecto adverso grave y sobre la relación entre beneficios y riesgos en ese grupo concreto.
Lo que me molesta en casos así no es que se revise una recomendación. Los especialistas deben cambiarla cuando la evidencia nueva lo justifique. El problema es utilizar la cualificación profesional como escudo frente a las preguntas.
Una persona sin formación médica puede plantear una preocupación bien fundamentada o una equivocada. Hay que contrastar esa preocupación con las pruebas disponibles. Llamar incompetente a quien pregunta, o invocar a Dunning y Kruger, sigue sin responder nada.
Entonces, ¿quién es realmente competente?
Hasta la palabra «competencia» puede despistarnos. En lugar de examinar un error concreto, casi sin darnos cuenta acabamos juzgando a la persona.
Kruger y Dunning estudiaron la relación entre el rendimiento en tareas específicas y lo que los participantes creían sobre sus propias capacidades. Sus investigaciones no permiten deducir cuánto entiende alguien de un tema a partir de un único comentario, por mucha seguridad que transmita. Tampoco justifican tratar cualquier desacuerdo con un experto como prueba de un defecto psicológico.
El problema se aprecia en sus propios datos de 1999. En el segundo experimento, el cuartil inferior de la prueba de lógica se situaba, de media, alrededor del percentil 12 y el superior alrededor del 86. Sin embargo, ambos grupos valoraban su posición de forma casi idéntica: en los percentiles 62 y 68, respectivamente [2]. El rendimiento real difería en 74 puntos percentiles; las autoevaluaciones, solo en seis. Estimar la propia posición respecto a los demás no equivale a estar seguro de una afirmación concreta, y las medias de un grupo tampoco nos dicen todo sobre cada individuo. Aun así, esas cifras muestran por qué no podemos partir de una autoevaluación alta y concluir que esa persona es poco competente.
Un título tampoco decide si una afirmación es verdadera. Nos da motivos para esperar un cierto nivel de formación, a veces muy alto. No nos exime de comprobar lo que se afirma.
Volvamos al alumno y la raíz cuadrada. La regla es correcta para los números reales. El error empieza cuando el alumno la convierte en una ley de todas las matemáticas. Alguien con credenciales mucho más impresionantes puede cometer un error parecido si olvida los límites de un modelo familiar.
A mí me interesa qué afirma alguien y cómo lo justifica. ¿Qué se ha observado y qué se está dando por supuesto? ¿En qué condiciones deja de sostenerse la conclusión? Podemos examinar todo eso sin buscar las respuestas en la biografía de quien habla.
En aquella discusión de Hacker News, el comentarista nunca explicó qué tenía de malo la propuesta biotecnológica. Se limitó a mencionar un efecto psicológico.
A partir de su respuesta es imposible saber si la propuesta tenía sentido.
Lo único que averiguamos es que a su autor le habían reservado un hueco en el diccionario, junto a dos psicólogos.
Referencias
- Hacker News. Debate en el que se invoca el efecto Dunning–Kruger contra otro participante, agosto de 2026. Debate.
- Kruger J, Dunning D. (1999). Unskilled and unaware of it: How difficulties in recognizing one’s own incompetence lead to inflated self-assessments. Journal of Personality and Social Psychology, 77(6), 1121–1134. DOI.
- Krueger J, Mueller RA. (2002). Unskilled, unaware, or both? The better-than-average heuristic and statistical regression predict errors in estimates of own performance. Journal of Personality and Social Psychology, 82(2), 180–188. PubMed.
- Nuhfer E et al. (2016). Random Number Simulations Reveal How Random Noise Affects the Measurements and Graphical Portrayals of Self-Assessed Competency. Numeracy, 9(1). DOI.
- Gignac GE, Zajenkowski M. (2020). The Dunning-Kruger effect is (mostly) a statistical artefact: Valid approaches to testing the hypothesis with individual differences data. Intelligence, 80, 101449. DOI.
- Fix B. (2022). The Dunning-Kruger Effect is Autocorrelation. Economics from the Top Down.
- Andersource. (2022). I can’t let go of “The Dunning-Kruger Effect is Autocorrelation”. Andersource.
- Jansen RA, Rafferty AN, Griffiths TL. (2021). A rational model of the Dunning–Kruger effect supports insensitivity to evidence in low performers. Nature Human Behaviour, 5, 756–763. DOI.
- McIntosh RD et al. (2022). Skill and self-knowledge: Empirical refutation of the dual-burden account of the Dunning–Kruger effect. Royal Society Open Science, 9, 191727. DOI.
- The Null Institute. (2026). Dunning–Kruger Reanalysis: The Scale, the Baseline, and the Error Curve. Nota de investigación.
- Moore DA, Healy PJ. (2008). The Trouble with Overconfidence. Psychological Review, 115(2), 502–517. DOI.
- JCVI. (7 de abril de 2021). Statement on use of the AstraZeneca COVID-19 vaccine. GOV.UK.