논쟁에서 할 말이 떨어졌을 때 이기는 손쉬운 방법이 있다. 상대가 ‘더닝–크루거 효과’를 보인다고 말하면 된다. 그 사람은 문제를 너무 몰라서 자신이 얼마나 모르는지조차 모른다는 뜻이다. 상대가 자신 있게 반박할수록 ‘진단’은 더욱 확실해 보인다. 이 말에 맞서기는 거의 불가능하다. 반박하는 행동 자체가 또 하나의 증거로 취급되기 때문이다.
이 수법에는 과학적으로 들리는 이름이 붙어 있지만, 실제 연구와의 관계는 꽤 복잡하다. 심리학자들은 몇몇 시험에서 성적이 낮은 참가자들이 다른 사람에 비해 자신의 성과를 더 높게 평가하는 경향을 발견했다. 연구진은 심리학적 설명을 내놓았고 실험에서도 이를 뒷받침하는 결과를 얻었다. 하지만 뒤이어 비슷한 그래프가 측정 방식 자체의 특성을 비롯한 다른 이유로도 나타날 수 있다는 사실이 밝혀졌다.
그렇다고 이 연구를 근거로 논쟁 상대의 자신감만 보고 그 사람이 주제를 얼마나 이해하는지 판단할 수는 없다.
2026년 8월, Hacker News에서 상당히 급진적인 생명공학 제안을 두고 토론이 벌어졌다. 한 댓글 작성자는 제안자의 이름도 사전에 ‘더닝–크루거 효과’ 바로 옆에 올려야겠다고 했다[1]. 그런데 그 댓글에는 제안의 내용에 대한 분석도, 반대하는 근거도 없었다. 심리학자 두 사람의 성만 거론하면 설명이 끝난다고 생각한 모양이다.
‘멍청함의 봉우리’는 어디에서 왔을까
어떤 분야를 조금 배웠을 뿐인데 자신감이 산꼭대기까지 치솟는 그림을 본 적이 있을 것이다. 흔히 ‘멍청함의 봉우리’(Mount Stupid)라고 부른다. 그다음에는 ‘절망의 계곡’이 나오고, 이어 ‘깨달음의 비탈길’을 따라 천천히 올라간다.
참 편리한 그래프다. 마음에 안 드는 토론 상대라면 누구든 그 위에 올려놓을 수 있다. 대개 꼭대기 근처에 말이다.
하지만 저스틴 크루거(Justin Kruger)와 데이비드 더닝(David Dunning)이 1999년에 발표한 논문에는 그런 그림이 없다[2]. 연구진은 한 사람이 학습을 계속하면서 자신감이 어떻게 변하는지도 조사하지 않았다. 서로 다른 참가자들에게 유머, 문법, 논리 과제를 내고, 다른 참가자들과 비교해 자신의 능력이 어느 정도인지 평가하도록 했다.
첫 번째 실험에서 성적이 하위 25%였던 참가자들은 실제로 백분위 약 12에 있었지만, 스스로는 백분위 약 58에 있다고 평가했다. 백분위는 집단 내 상대적인 위치를 뜻한다. 백분위 20이라면 참가자의 약 20%가 나보다 낮은 점수를 받았다는 뜻이다.
점수가 높은 참가자들은 자기평가도 더 높았지만, 실제 성적이 올라가는 폭에 비하면 자기평가의 상승 폭은 훨씬 작았다. 초보자가 반드시 거친다는 자신감의 ‘정점’은 발견되지 않았다.
크루거와 더닝은 과제를 해내는 능력과 자신의 실수를 알아차리는 능력이 일부 같은 기술에 의존하기 때문에 이런 현상이 생긴다고 설명했다. 체스를 막 배우기 시작한 사람은 세 수 뒤에 체크메이트를 당할 위험을 못 볼 수 있다. 자신이 유리하다고 생각하는 이유가 꼭 오만함은 아니다. 위험을 발견할 만한 지식이 아직 부족한 것일 수도 있다.
연구진은 한 실험에서 참가자들에게 논리적 추론을 가르쳤다. 교육을 받은 뒤 자기평가의 정확도가 높아졌다. 이 결과는 연구진이 제안한 메커니즘을 뒷받침하는 중요한 근거다. 1999년 연구를 정작 논문에 나오지도 않는 ‘멍청함의 봉우리’ 그림 한 장으로 치부하는 것도 부당하다.
시간이 지나자 연구자들은 곡선이 측정 방식 자체에서 비롯된 건 아닌지, 좀 더 소박한 설명도 검토하기 시작했다.
배웠다고 다 이해한 건 아니다
그래프를 둘러싼 논쟁 뒤에는 더 큰 문제가 있다. 시험 점수와 자기평가를 모두 갖고도, 연구자들은 참가자가 왜 실수했는지 언제나 알아낼 수는 없다. 그런데 우리는 인터넷에서 자신만만한 댓글 하나를 보고 낯선 사람의 전문성을 판단하려 들 때가 있다.
어떤 분야를 아는 것과 자신이 어디까지 아는지 아는 것은 다르다.
학교에서 배우는 익숙한 규칙이 하나 있다. 음수의 제곱근은 구할 수 없다는 것이다.
학생은 그 규칙을 외우고 시험도 잘 봤다. 이제 남에게도 설명할 자신이 있다. 그런데 수학 교수가 방정식 x² = −1에도 해가 있다고 말하면 화를 낼지 모른다. 학교에서는 분명 다르게 배웠으니까.
핵심은 두 사람이 서로 다른 수 체계에 대해 말한다면 둘 다 옳을 수 있다는 데 있다. 실수 범위에서는 해가 없다. 하지만 복소수 범위에는 i와 −i라는 두 해가 있다. 여기서 i² = −1이다.
교수는 학교에서 배운 규칙이 실수 범위에서 성립한다는 사실을 안다. 수 체계를 확장하면 기존에는 없었던 해가 등장한다.
학생은 규칙을 정확히 외웠지만 그것이 특정한 수 체계에서만 성립한다는 사실은 모를 수 있다. 올바르게 배운 지식에서 잘못된 결론이 나오는 순간이다.
덧붙이자면 이 사례는 더닝과 크루거의 원래 가설에도 잘 들어맞는다. 문제를 올바르게 풀 지식뿐 아니라 자신의 오류를 알아차릴 지식도 부족할 수 있다는 것이다. 이것이 무능력의 ‘이중 부담’이다. 학생에게만 해당하는 이야기도 아니다. 전문가 역시 자신이 아는 영역을 벗어났는데도 이를 깨닫지 못할 수 있다. 그러니 심리학 용어 하나를 붙이는 것으로는 아무것도 설명되지 않는다. 추론의 어느 부분이 잘못됐는지 보여줘야 한다.
나는 전문성을 둘러싼 논쟁에서 바로 이 구분에 오래 관심을 가져왔다. 어떤 사람이 전공 지식을 익히고, 정의를 외우고, 시험을 통과해 학위를 받고 그 직업에 종사할 자격까지 갖췄다고 하자. 정해진 기준으로 보면 그는 그 분야의 역량을 갖췄다. 하지만 그 기준 자체를 검토하고 숨은 가정을 찾아내며 익숙한 모델 밖으로 나갈 능력은 얼마나 갖췄을까?
전문 자격은 전문가를 신뢰할 이유가 된다. 그 뒤에는 교육과 실무 경험, 자격 요건이 있기 때문이다. 그렇다고 그가 내리는 모든 결론이 옳다는 증명은 아니다. 의사는 진단을 잘못할 수 있고, 수학자는 잘못된 가정을 놓칠 수 있으며, 연구자는 자신의 데이터가 뒷받침하는 범위를 과대평가할 수 있다.
주장이 맞는지 판단하려면 말한 사람의 이력보다 그 주장을 뒷받침하는 근거를 살펴야 한다.
아래 그림은 분야에 관한 지식과 추론을 스스로 검증하는 능력을 서로 다른 축으로 보여준다.
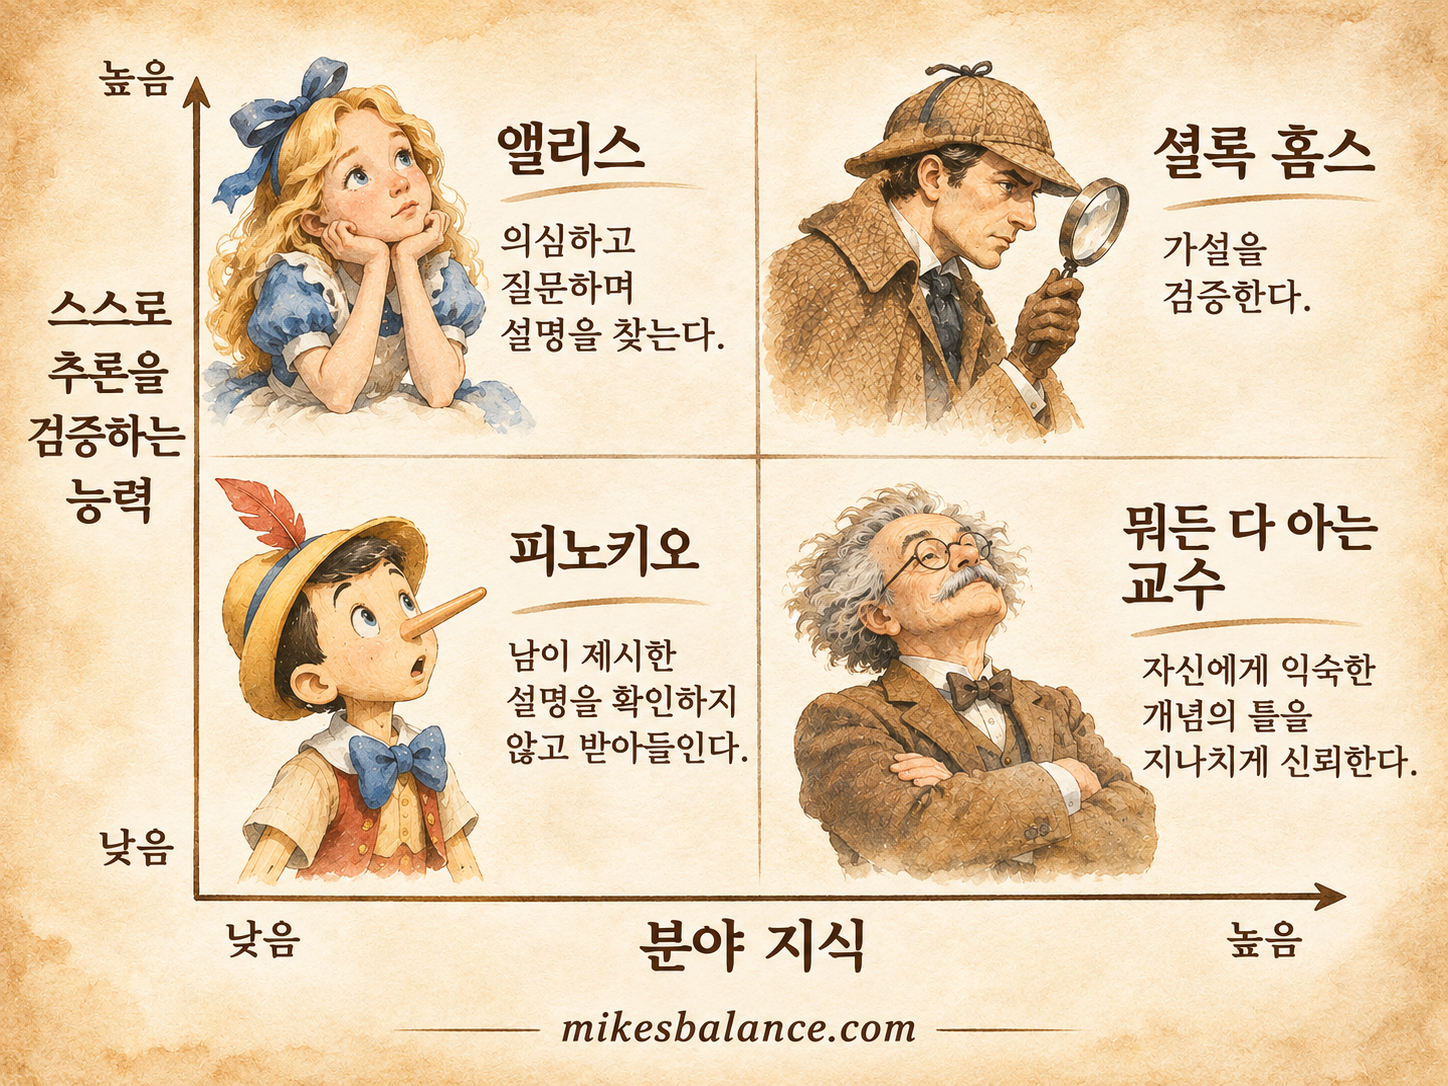
실제 일을 할 때는 두 능력이 모두 필요하다. 지식은 이미 검증된 것을 처음부터 다시 발견하는 수고를 덜어준다. 독립적인 추론 능력은 조건이 달라졌거나 익숙한 설명에서 중요한 부분이 빠졌음을 알아차리게 한다.
관련 학위가 없는 사람이 전문가의 오류를 정확히 짚을 수도 있고, 이미 잘 알려진 사실 몇 가지만 확인해도 그 반론이 무너질 수도 있다. 어느 쪽인지는 반론 자체를 검증해 봐야 안다.
자신감만으로는 누가 더 깊이 이해하는지 알 수 없다. 수학 교수는 복소수가 존재한다는 사실을 확신할 수 있고, 그 확신에는 충분한 근거가 있다. 반면 학생은 학교에서 배운 규칙이 모든 수학에 통한다고 생각해 똑같은 확신으로 반대할 수 있다.
통계는 어떻게 ‘과신’을 있는 것처럼 보이게 할까
실력이 똑같은 두 사람을 생각해 보자. 둘 다 평균적으로 문제의 70%를 맞힌다. 한 사람은 운 나쁘게 잘 풀리지 않는 문제들이 나와 60%만 맞혔고, 다른 사람은 운이 좋아 80%를 맞혔다. 두 사람 모두 자신의 실력을 70%라고 평가했다. 누가 자신을 과대평가했을까? 사실 둘 다 아니다. 하지만 이번 시험 점수만 기준으로 삼으면 첫 번째 사람은 10%포인트만큼 ‘과대평가’했고, 두 번째 사람은 같은 10%포인트만큼 ‘과소평가’한 것처럼 보인다.
이제 시험 점수를 기준으로 참가자들을 나눠보자. 하위 집단에는 이번 시험에서 운이 나빴던 사람이 상대적으로 많이 모이고, 상위 집단에는 운이 좋았던 사람이 많이 모인다. 그러면 익숙한 곡선이 나타난다. 성적이 낮은 사람은 자신을 과대평가하고 성적이 높은 사람은 과소평가하는 듯하다. 하지만 이 예시에서는 누구도 자신의 실제 실력을 잘못 평가하지 않았다.
계산 방식 자체에도 함정이 있다. ‘자기평가 오차’를 자기평가에서 시험 점수를 뺀 값으로 정의해 놓고, 그 차이를 다시 같은 시험 점수와 비교하는 것이다. 자기평가가 일정하다면 시험 점수가 10점 높아질 때마다 계산된 ‘오차’는 자동으로 10점 작아진다. 비교식의 양쪽에 같은 시험 점수가 들어가기 때문이다.
그렇다고 더닝–크루거 효과가 전부 허구라는 뜻은 아니다. 그래프의 모양만 보고는 왜 그런 모양이 나왔는지 알 수 없다는 뜻이다. 요아힘 크루거(Joachim Krueger)와 로스 뮐러(Ross Mueller)는 이 문제를 지적했다[3]. 누퍼(Nuhfer)와 동료들[4], 지냐크(Gignac)와 자옌코프스키(Zajenkowski)[5]는 무작위 잡음과 측정 방식의 영향을 연구했다.
여기 재미있는 사실이 하나 있다. 1999년 논문의 공동 저자인 저스틴 크루거(Justin Kruger)와 2002년 비판 논문의 저자인 요아힘 크루거(Joachim Krueger)는 서로 다른 사람이다. 이걸 모르면 크루거가 3년 만에 생각을 바꿔 자기 연구를 직접 반박했다고 오해할 수도 있다.
블레어 픽스(Blair Fix)는 무작위 변수만으로도 비슷한 곡선을 만들어냈다[6]. 다만 그 모델은 애초에 자기평가와 실제 성과가 전혀 관련이 없다고 가정한다. 유용한 수학적 검증이지만 현실의 사람들을 그대로 묘사하는 모델은 아니다. 비판자들도 바로 그 점을 지적했다[7]. 한편 얀센(Jansen)과 동료들은 성적이 낮은 참가자들이 자신의 오류에 관한 정보를 실제로 덜 잘 활용한다는 근거를 발견했다[8].
곡선은 분명 나타난다. 다만 어느 부분이 심리적 메커니즘 때문이고 어느 부분이 측정 방식 때문인지는 아직 구분해야 한다. 참가자의 성격을 추측할 것이 아니라, 이를 가려낼 다른 데이터가 필요하다.
같은 시험, 전혀 다른 두 종류의 자기평가
‘자신을 과대평가한다’는 말은 정확히 무엇을 뜻할까? 맞힌 문제 수를 잘못 짐작했다는 뜻일까, 아니면 다른 사람들과 비교한 자신의 위치를 잘못 짐작했다는 뜻일까? 얼핏 비슷해 보여도 실제로는 서로 다른 두 가지 질문이다.
2022년 매킨토시(McIntosh)와 동료들의 실험에서 참가자들은 행렬 추론 문제를 푼 뒤 자신이 몇 문제를 맞혔는지, 다른 학생들 사이에서 자신의 순위가 어느 정도인지 스스로 추정했다[9]. 우리는 The Null Institute에서 참가자 151명의 공개 데이터를 독립적으로 다시 계산했다[10]. 아래는 사전 검사에서 하위 25%에 속한 38명의 결과다.
| 평가 항목 | 참가자의 자기평가 | 실제 결과 |
|---|---|---|
| 정답률 | 76.0% | 76.1% |
| 다른 사람들과 비교한 위치(백분위) | 51.2 | 19.8 |
첫째 줄에서는 추정치와 실제 결과가 거의 같다. 둘째 줄에서는 백분위 순위가 31.4포인트나 차이 난다. 같은 참가자들이 평균적으로는 몇 문제를 맞혔는지 꽤 정확하게 짚었으면서도, 다른 사람들과 비교한 자신의 위치는 크게 높여 잡은 것이다.
그렇다고 참가자 한 명 한 명의 추정이 정확했던 것은 아니다. 평균적으로만 거의 맞아떨어졌다. 38명 중 22명은 정답 수를 과대평가했고, 14명은 과소평가했으며, 2명은 정확히 맞혔다. 평균 절대오차는 7.7%포인트였다. 서로 반대 방향의 오차가 평균에서 일부 상쇄된 셈이다.
비교에는 한계도 있다. 참가자들에게는 에든버러대학교 학생들 사이에서 자신의 위치를 추정하라고 했지만, 우리가 계산한 백분위는 연구 표본 안에서의 순위다. 자기평가 척도도 특이했다. 이 척도에서 0은 정답률 50%, 즉 무작위로 답을 골랐을 때의 기대 수준을 뜻했다. 재계산에는 이 척도를 반영했지만 참가자 각자가 그 의미를 어떻게 이해했는지는 알 수 없다[9], [10].
전체 표본에서는 오히려 참가자들이 자신의 점수를 평균 7.64%포인트 낮게 평가했다. 그런데도 실력과 자기평가 오차 사이에는 음의 관계가 유지됐다. 상위 25% 참가자들의 평균 정답률은 약 97%였다. 그 정도면 더 높게 평가할 여지는 거의 없지만 낮게 평가할 여지는 충분하다.
여기서 중요한 것은 한 사람이 실제로 맞힌 문제 수는 꽤 정확하게 평가하면서도 다른 사람들 사이에서 자신의 위치는 크게 잘못 판단할 수 있다는 점이다. 절대적 자기평가와 상대적 자기평가의 차이는 오래전부터 알려져 있다[11]. 우리가 한 일은 새로운 심리학 효과를 발견한 것이 아니라 특정 데이터의 독립적인 재검증이다. 자세한 표와 방법, 코드는 The Null Institute의 연구 노트에 정리했다.
전문가도 권고를 수정한다
코로나19 팬데믹 동안 무엇을 알고 있는지, 무엇을 이해하는지, 그리고 실제로 어떤 결정을 내려야 하는지의 차이는 특히 뚜렷하게 드러났다.
백신의 안전성, 감염 위험, 개별 조치의 타당성은 각각 다른 데이터를 필요로 했다. 그런데도 전문적인 권고가 비전문가는 그저 받아들이면 되는 완성된 답처럼 여겨질 때가 있었다. 의문이 제기되면 반론의 내용보다 질문한 사람의 무지를 문제 삼기도 했다.
아스트라제네카(AstraZeneca) 백신 사례는 이런 접근이 왜 문제인지 보여준다.
대규모 접종이 시작된 뒤 혈전과 혈소판 감소가 함께 나타나는 드문 사례들이 보고됐다. 2021년 4월 7일 영국 예방접종·면역 공동위원회(JCVI)는 추가적인 위험 요인이 없는 30세 미만 성인에게 대체 백신이 있다면 그것을 제공하도록 권고했다[12].
이는 심각한 합병증에 관한 새 데이터와 해당 집단에서의 접종 이익과 위험을 다시 따져 권고를 바꾼 사례였다.
이런 이야기에서 내가 못마땅하게 생각하는 것은 권고를 바꾸는 일 자체가 아니다. 전문가라면 새로운 데이터를 보고 판단을 수정하는 것이 당연하다. 더 나쁜 것은 전문 자격을 내세워 질문을 막는 태도다.
의학을 전공하지 않은 사람이 제기하는 우려도 타당할 수 있고 틀릴 수 있다. 어느 쪽인지는 현재 가진 데이터로 그 우려의 내용을 검토해야 한다. 질문한 사람을 무능하다고 부르거나 더닝–크루거 효과를 들먹인다고 답변이 되는 것은 아니다.
여기서 정말 전문가인 사람은 누구일까?
이쯤 되면 ‘전문성’이라는 말 자체가 오히려 방해가 된다. 특정한 오류를 따지는 대화가 어느새 한 사람 전체를 평가하는 이야기로 바뀌기 때문이다.
크루거와 더닝은 특정 과제의 수행 결과와 참가자들이 자신의 능력을 어떻게 평가하는지의 관계를 연구했다. 이 연구만으로 자신감 넘치는 댓글 하나를 보고 어떤 분야를 얼마나 깊이 이해하는지 알아낼 수는 없다. 전문가에게 반대했다는 이유만으로 그것을 심리적 결함의 징후라고 간주할 근거는 더더욱 없다.
이는 그들이 1999년에 발표한 데이터에서도 드러난다. 두 번째 실험의 논리 시험에서 하위 25% 참가자들의 실제 평균 위치는 12백분위, 상위 25%는 86백분위였다. 그런데 자신의 순위를 평가한 값은 각각 62백분위와 68백분위로 거의 비슷했다[2]. 실제 성과의 차이는 74백분위포인트였지만 자기평가의 차이는 겨우 6백분위포인트였다. 물론 집단 내 순위를 추정하는 것과 특정 주장에 대한 확신은 같지 않으며, 집단 평균이 개개인의 차이를 모두 보여주는 것도 아니다. 이 수치만 봐도 자기평가가 높다는 이유만으로 그 사람의 능력이 낮다고 단정해서는 안 되는 이유가 분명해진다.
학위 역시 그 자체로 특정 주장의 진위를 알려주지 않는다. 상당한 훈련을 받았으리라고 기대할 근거는 되지만, 개별 주장을 검증하는 일을 대신하지는 않는다.
음수의 제곱근을 배우던 학생을 다시 떠올려 보자. 그가 외운 규칙은 실수 범위에서는 옳다. 문제는 그 규칙을 수학 전체의 성질로 확대할 때 생긴다. 훨씬 화려한 경력을 가진 전문가라도 익숙한 모델의 적용 범위를 놓치면 비슷한 실수를 할 수 있다.
내가 궁금한 것은 그 사람이 정확히 무엇을 주장하고, 무엇을 근거로 드는지다. 논증에서 사실은 어디까지인가? 가정은 무엇인가? 어떤 조건에서 결론이 더는 성립하지 않는가? 이런 질문이라면 상대의 이력으로 실력을 추측하는 대신 오류 자체를 따져볼 수 있다.
처음에 이야기했던 Hacker News 토론으로 돌아가 보자. 그 댓글 작성자는 자신의 답변에서 생명공학 제안의 어떤 부분이 잘못됐는지 끝내 설명하지 않았다. 그저 심리학 효과의 이름을 꺼냈다.
그 답변만으로는 제안 자체가 타당했는지 판단할 길이 없다.
확실히 알 수 있었던 건, 누군가 제안자의 이름을 두 심리학자 이름 옆에 사전에 실어야겠다고 했다는 것뿐이다.
참고문헌
- Hacker News. 2026년 8월, 한 토론 참여자가 상대에게 ‘더닝–크루거 효과’라는 딱지를 붙인 논의. 토론 원문.
- Kruger J, Dunning D. (1999). Unskilled and unaware of it: How difficulties in recognizing one’s own incompetence lead to inflated self-assessments. Journal of Personality and Social Psychology, 77(6), 1121–1134. DOI.
- Krueger J, Mueller RA. (2002). Unskilled, unaware, or both? The better-than-average heuristic and statistical regression predict errors in estimates of own performance. Journal of Personality and Social Psychology, 82(2), 180–188. PubMed.
- Nuhfer E et al. (2016). Random Number Simulations Reveal How Random Noise Affects the Measurements and Graphical Portrayals of Self-Assessed Competency. Numeracy, 9(1). DOI.
- Gignac GE, Zajenkowski M. (2020). The Dunning-Kruger effect is (mostly) a statistical artefact: Valid approaches to testing the hypothesis with individual differences data. Intelligence, 80, 101449. DOI.
- Fix B. (2022). The Dunning-Kruger Effect is Autocorrelation. Economics from the Top Down.
- Andersource. (2022). I can’t let go of “The Dunning-Kruger Effect is Autocorrelation”. Andersource.
- Jansen RA, Rafferty AN, Griffiths TL. (2021). A rational model of the Dunning–Kruger effect supports insensitivity to evidence in low performers. Nature Human Behaviour, 5, 756–763. DOI.
- McIntosh RD et al. (2022). Skill and self-knowledge: Empirical refutation of the dual-burden account of the Dunning–Kruger effect. Royal Society Open Science, 9, 191727. DOI.
- The Null Institute. (2026). Dunning–Kruger Reanalysis: The Scale, the Baseline, and the Error Curve. 연구 노트.
- Moore DA, Healy PJ. (2008). The Trouble with Overconfidence. Psychological Review, 115(2), 502–517. DOI.
- JCVI. (2021년 4월 7일). Statement on use of the AstraZeneca COVID-19 vaccine. GOV.UK.