Il existe un moyen très commode de gagner une dispute quand on n’a plus d’arguments : accuser son interlocuteur d’être victime de l’effet Dunning–Kruger. Il connaît si mal le sujet qu’il ne se rend même pas compte de son incompétence. Et plus il vous contredit avec assurance, plus le diagnostic paraît évident. Difficile de se défendre : chaque objection peut servir de symptôme supplémentaire.
Cette manière de faire porte un nom qui sonne scientifique. Sauf que son rapport avec la science est un peu plus compliqué. Des psychologues ont effectivement observé que, dans certains tests, les personnes obtenant les moins bons résultats tendent à surestimer davantage leur performance par rapport aux autres. Ils ont proposé une explication psychologique et obtenu des résultats expérimentaux qui l’étayaient. On a découvert ensuite qu’un tableau semblable pouvait aussi apparaître pour d’autres raisons, notamment à cause de la manière dont on mesure les performances.
Ce que ces études ne permettent pas, en revanche, c’est de déduire la compétence de quelqu’un de l’assurance avec laquelle il défend son avis.
En août 2026, une proposition assez radicale dans le domaine des biotechnologies faisait débat sur Hacker News. Un participant a répondu à son auteur que son nom mériterait de figurer dans le dictionnaire, juste à côté de l’effet Dunning–Kruger [1]. Dans cette réponse, pas d’analyse de la proposition, pas d’argument contre elle. Deux noms de famille étaient apparemment censés suffire.
D’où vient le « mont de la stupidité » ?
Vous avez sans doute déjà vu ce graphique : quelqu’un découvre à peine un sujet et le voilà déjà au sommet de la confiance en soi, sur le « mont de la stupidité » (Mount Stupid). Viennent ensuite la « vallée du désespoir » et la longue remontée vers la « pente de l’illumination ».
Un graphique bien pratique. On peut y placer à peu près n’importe quel interlocuteur agaçant, de préférence tout près du sommet.
Seulement voilà : ce dessin ne figure nulle part dans l’étude publiée en 1999 par Justin Kruger et David Dunning [2]. Les auteurs n’ont même pas étudié l’évolution de la confiance d’une personne au fil de son apprentissage. Ils ont demandé à différentes personnes de résoudre des exercices d’humour, de grammaire et de logique, puis d’estimer leurs capacités par rapport aux autres participants.
Dans la première expérience, les participants du quart inférieur se situaient, selon leurs résultats réels, autour du 12e percentile, mais s’évaluaient eux-mêmes autour du 58e. Un percentile indique la position dans un groupe : être au 20e percentile signifie qu’environ 20 % des participants ont obtenu un résultat inférieur au vôtre.
Les participants les plus performants s’évaluaient eux aussi plus favorablement, mais d’un groupe à l’autre, leurs estimations augmentaient bien moins vite que leurs résultats réels. L’étude n’a donc mis en évidence aucun pic inévitable de confiance excessive chez les débutants.
Kruger et Dunning supposaient qu’accomplir une tâche et repérer ses propres erreurs mobilisent en partie les mêmes compétences. Un débutant aux échecs peut ne pas voir qu’un mat le menace dans trois coups. S’il se croit en bonne position, ce n’est pas forcément par arrogance : il lui manque peut-être simplement les connaissances nécessaires pour voir le danger.
Dans l’une des expériences, les chercheurs ont formé les participants au raisonnement logique. Après cette formation, leurs autoévaluations sont devenues plus précises. C’est un argument sérieux en faveur du mécanisme proposé. Il serait donc injuste de résumer l’étude de 1999 à ce seul graphique trompeur, qui n’y figure même pas.
Avec le temps, d’autres chercheurs ont commencé à tester des explications plus terre à terre de cette courbe, liées cette fois à la façon dont les mesures sont construites.
Connaître un sujet ne suffit pas à le comprendre
Derrière la querelle des graphiques se cache une question plus générale. Même lorsqu’ils disposent des résultats aux tests et des autoévaluations, les chercheurs ne peuvent pas toujours déterminer pourquoi les participants se trompent. Et pourtant, un seul commentaire écrit avec assurance sur Internet nous suffit parfois pour juger de la compétence de son auteur.
Il faut distinguer deux choses : connaître un sujet et savoir où s’arrêtent ses propres connaissances.
Il y a cette vieille règle apprise à l’école : on ne peut pas calculer la racine carrée d’un nombre négatif.
Un élève apprend la règle par cœur, réussit son contrôle, obtient une excellente note. Le voilà prêt à l’expliquer à tout le monde. Mais qu’un professeur de mathématiques lui affirme que l’équation x² = −1 possède des solutions, et l’élève risque de protester. À l’école, on lui a pourtant enseigné le contraire !
Le problème, c’est que les deux ont raison, tant qu’ils parlent de systèmes de nombres différents. Dans l’ensemble des nombres réels, il n’y a pas de solution. Dans celui des nombres complexes, il y en a deux : i et −i, avec i² = −1.
Le professeur sait que la règle scolaire ne vaut que pour les nombres réels. Lorsqu’on élargit l’ensemble des nombres, des solutions apparaissent là où il n’y en avait pas.
L’élève, lui, peut retenir parfaitement la formule sans comprendre qu’elle ne s’applique qu’à un cadre mathématique particulier. Et voilà comment une connaissance correcte mène à une conclusion fausse.
Soit dit en passant, cet exemple correspond assez bien à l’hypothèse initiale de Dunning et Kruger. On peut manquer de connaissances à la fois pour résoudre correctement un problème et pour reconnaître son erreur. C’est le « double fardeau » de l’incompétence. Et cela ne concerne pas uniquement les élèves : même un spécialiste peut dépasser les limites de son savoir sans s’en rendre compte. L’étiquette ne suffit donc pas à expliquer quoi que ce soit. Il faut montrer précisément où le raisonnement échoue.
C’est précisément cette différence qui m’intéresse depuis longtemps dans les débats sur l’expertise. Quelqu’un étudie une discipline, apprend ses définitions, passe ses examens, obtient un diplôme et le droit d’exercer. Selon les critères établis, il est compétent. Mais dans quelle mesure sait-il vérifier ces critères eux-mêmes, déceler les hypothèses cachées et sortir du modèle auquel il est habitué ?
Une qualification professionnelle donne de bonnes raisons de faire confiance à un spécialiste : elle repose sur une formation, de la pratique et des exigences à remplir. Mais elle ne garantit pas la justesse de chacune de ses conclusions. Un médecin peut se tromper de diagnostic ; un mathématicien peut partir d’une hypothèse fausse sans le voir ; un chercheur peut surestimer ce que ses données permettent d’affirmer.
Pour vérifier une affirmation précise, il faut toujours examiner ce qui la fonde, pas le CV de son auteur.
Le schéma ci-dessous distingue la connaissance du sujet de la capacité à vérifier soi-même un raisonnement.
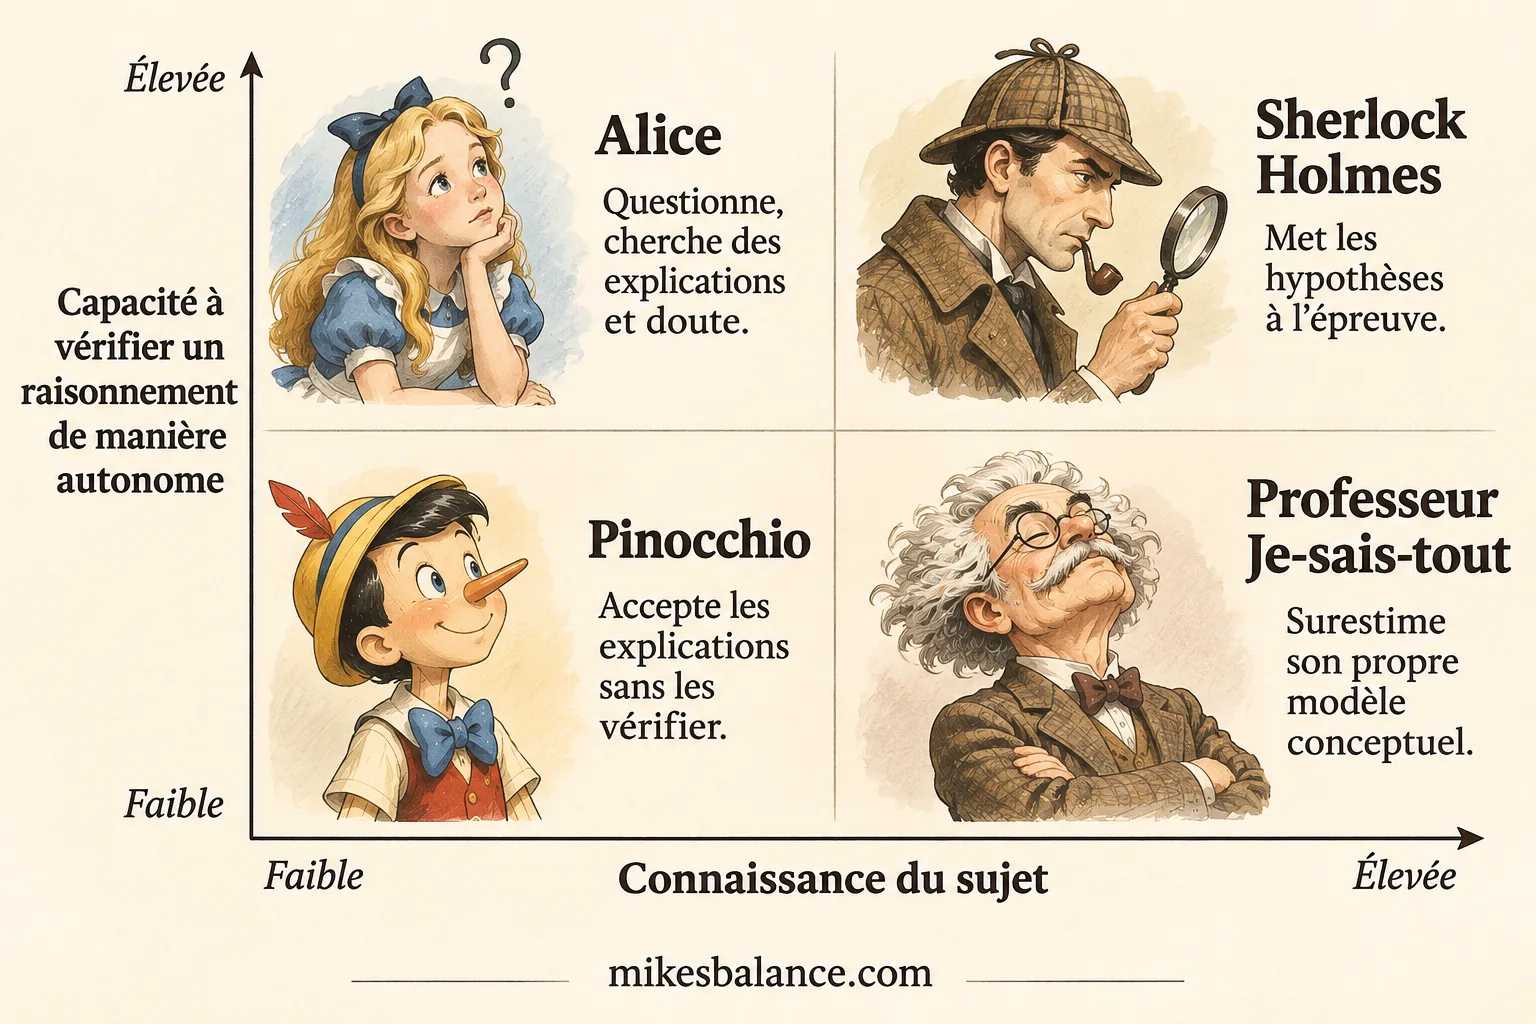
Dans la pratique, il faut les deux. Les connaissances nous évitent de redécouvrir ce que d’autres ont déjà vérifié. Le raisonnement autonome nous aide à remarquer que les conditions ont changé, ou qu’une explication familière laisse de côté un élément essentiel.
L’objection d’une personne sans formation spécialisée peut révéler une erreur commise par un expert. Elle peut aussi s’effondrer dès qu’on la confronte à des faits bien établis. Ce qui permet de trancher, c’est l’examen de l’objection elle-même.
La seule assurance ne dit pas lequel des deux comprend le mieux la question. Un professeur de mathématiques peut être absolument certain de l’existence des nombres complexes, avec d’excellentes raisons. Un élève peut affirmer le contraire avec autant d’assurance s’il croit que sa règle scolaire vaut pour toutes les mathématiques.
Quand les statistiques donnent l’illusion d’un excès de confiance
Imaginons deux personnes ayant exactement le même niveau de préparation. Chacune résout correctement 70 % des exercices en moyenne. La première tombe sur une série de questions défavorable et obtient 60 %. La seconde a plus de chance et atteint 80 %. Toutes deux évaluent leur niveau à 70 %. Laquelle s’est surestimée ? En réalité, aucune. Mais si l’on compare leur estimation au score obtenu à ce test, la première paraît se surestimer de 10 points de pourcentage et la seconde se sous-estimer d’autant.
Répartissons maintenant les participants en groupes selon leur résultat au test. Parmi ceux qui finissent en bas du classement, il y aura davantage de personnes ayant manqué de chance. Parmi ceux qui terminent en haut, davantage de personnes favorisées par les questions. Et voici la courbe bien connue : les moins bons semblent se surestimer, les meilleurs se sous-estimer. Pourtant, dans notre exemple, personne ne s’est trompé sur son niveau réel de préparation.
Il y a aussi un piège purement arithmétique. On calcule l’« erreur d’autoévaluation » en soustrayant le résultat au test de l’estimation personnelle, puis on compare cette différence au résultat de ce même test. Si l’estimation personnelle ne change pas, 10 points supplémentaires au test font automatiquement diminuer l’« erreur » calculée de 10 points. La même valeur intervient des deux côtés de la comparaison.
Cela ne veut pas dire que l’effet Dunning–Kruger a été inventé de toutes pièces. Cela signifie que la forme d’une courbe ne suffit pas à expliquer son origine. Joachim Krueger et Ross Mueller ont signalé ce problème [3]. Nuhfer et ses collègues [4], ainsi que Gignac et Zajenkowski [5], ont étudié le rôle du bruit aléatoire et des méthodes de mesure.
Au passage, un détail amusant : Justin Kruger, coauteur de l’étude de 1999, et Joachim Krueger, qui a publié une critique en 2002, sont deux personnes différentes. On pourrait sinon croire que Kruger a changé d’avis trois ans plus tard pour se réfuter lui-même.
Blair Fix a même obtenu une courbe semblable à partir de variables aléatoires [6]. Mais son modèle suppose d’emblée que l’autoévaluation et la performance sont indépendantes. C’est un test mathématique utile, pas un portrait de personnes réelles, comme l’ont souligné ses critiques [7]. De leur côté, Jansen et ses collègues ont trouvé des éléments suggérant que les participants les moins performants exploitent effectivement moins bien les informations sur leurs propres erreurs [8].
La courbe existe bel et bien. Reste à savoir quelle part de sa forme relève de la psychologie et quelle part découle de la mesure. Pour y répondre, il faut d’autres données, pas des suppositions sur le caractère des participants.
Un même test, deux autoévaluations très différentes
Au fond, que signifie « se surestimer » ? Se tromper sur le nombre de bonnes réponses ? Ou mal évaluer sa place par rapport aux autres ? Les deux questions semblent proches. En pratique, elles portent sur deux mesures différentes.
Dans une étude publiée en 2022, McIntosh et ses collègues ont fait résoudre des problèmes de matrices à des participants. Ceux-ci ont ensuite eux-mêmes estimé le nombre de leurs bonnes réponses et leur position par rapport à d’autres étudiants [9]. Au sein de The Null Institute, nous avons refait indépendamment les calculs à partir des données publiées de 151 personnes [10]. Voici les résultats des 38 participants appartenant au quart inférieur au test préliminaire :
| Que devaient-ils estimer ? | Autoévaluation | Résultat réel |
|---|---|---|
| Part de bonnes réponses | 76,0 % | 76,1 % |
| Rang parmi les autres (percentile) | 51,2 | 19,8 |
Sur la première ligne, l’estimation et le résultat réel coïncident presque parfaitement. Sur la seconde, l’écart atteint 31,4 points de percentile. Les mêmes personnes ont donc, en moyenne, assez bien estimé combien de problèmes elles avaient résolus, mais considérablement surestimé leur position par rapport aux autres.
Cette concordance n’est toutefois vraie qu’en moyenne. Parmi les 38 personnes, 22 ont surestimé le nombre de leurs bonnes réponses, 14 l’ont sous-estimé et deux l’ont évalué exactement. L’erreur absolue moyenne était de 7,7 points de pourcentage. Une partie des erreurs en sens opposé s’est annulée.
Cette comparaison a ses limites. On demandait aux participants d’estimer leur rang parmi les étudiants de l’université d’Édimbourg, tandis que nous avons calculé le percentile réel à l’intérieur de l’échantillon étudié. L’échelle d’autoévaluation avait aussi une particularité : son zéro correspondait à 50 % de bonnes réponses, le résultat attendu en répondant au hasard. Notre recalcul tient compte de cette échelle, mais nous ne pouvons pas savoir comment chaque participant l’a comprise [9], [10].
Sur l’ensemble de l’échantillon, les participants ont même, en moyenne, sous-estimé leurs résultats de 7,64 points de pourcentage. Pourtant, la relation entre la performance au test préliminaire et l’erreur d’autoévaluation restait négative. Dans le quart supérieur, le résultat moyen atteignait environ 97 % : il ne restait presque aucune marge pour se surestimer, et beaucoup pour se sous-estimer.
Connaître son score et connaître son rang parmi les autres, ce n’est donc pas la même chose. On peut savoir assez précisément combien de tâches on a réussies tout en se trompant lourdement sur sa place dans un groupe. La distinction entre autoévaluation absolue et relative est connue depuis longtemps [11]. Nous avons vérifié de façon indépendante un jeu de données précis ; nous n’avons pas découvert un nouvel effet psychologique. Les tableaux détaillés, la méthode et le code figurent dans la note de recherche de The Null Institute.
Quand les spécialistes revoient leurs recommandations
Pendant la pandémie de COVID-19, l’écart entre savoir, compréhension et décision pratique est apparu avec une netteté particulière.
La sécurité des vaccins, les risques d’infection et l’utilité de chaque mesure devaient être évalués à partir de données différentes. Pourtant, les recommandations étaient souvent perçues comme des réponses toutes faites que les non-spécialistes n’avaient plus qu’à accepter. On pouvait alors écarter leurs doutes en invoquant une prétendue incompétence, plutôt que d’examiner leurs objections sur le fond.
L’histoire du vaccin AstraZeneca montre pourquoi cette approche pose problème.
Après le début des campagnes de vaccination de masse, des cas rares associant des thromboses et une baisse du nombre de plaquettes ont été signalés. Le 7 avril 2021, le comité britannique de vaccination et d’immunisation (JCVI) a recommandé de proposer, lorsque c’était possible, un autre vaccin aux adultes de moins de 30 ans ne présentant pas de facteurs de risque supplémentaires [12].
Il s’agissait d’une révision des recommandations fondée sur de nouvelles données concernant une complication grave et le rapport bénéfice-risque pour ce groupe précis.
Ce qui m’agace dans ce genre d’histoire, ce n’est pas que les recommandations changent. Les spécialistes doivent justement tenir compte des nouvelles données. Le problème, c’est quand la qualification sert de bouclier contre les questions.
Les inquiétudes d’une personne sans formation médicale peuvent être fondées ou non. Pour le savoir, il faut examiner les données disponibles. Traiter cette personne d’incompétente ou brandir Dunning et Kruger ne répond pas à sa question.
Qui est vraiment compétent, ici ?
Le mot même de « compétence » finit par brouiller les choses : au lieu d’examiner une erreur précise, on se met presque sans le remarquer à juger la personne tout entière.
Kruger et Dunning étudiaient le rapport entre la réussite à certaines tâches et la perception qu’avaient les participants de leurs propres capacités. Leurs travaux ne permettent pas de déduire d’un seul commentaire assuré à quel point quelqu’un maîtrise un sujet. Ils permettent encore moins de voir dans tout désaccord avec un professionnel la preuve d’un défaut psychologique.
On le voit jusque dans leurs données de 1999. Dans la deuxième expérience, le quart inférieur se situait en moyenne au 12e percentile pour le test de logique, et le quart supérieur au 86e. Pourtant, les deux groupes estimaient leur propre rang presque de la même façon : au 62e et au 68e percentile respectivement [2]. Les résultats réels étaient séparés par 74 points de percentile, les autoévaluations par six seulement. Bien sûr, estimer son rang n’est pas la même chose qu’être sûr d’une affirmation précise ; les moyennes de groupe ne disent pas tout des individus non plus. Mais ces chiffres suffisent déjà à montrer pourquoi une autoévaluation élevée ne permet pas de conclure, à rebours, à une faible compétence.
Et un diplôme ne permet pas davantage de savoir si une affirmation particulière est vraie. Il donne des raisons d’attendre une certaine préparation, parfois très solide, mais ne remplace pas la vérification de ce qui est avancé.
Revenons à notre élève et à sa racine carrée. Sa règle est juste dans l’ensemble des réels. L’erreur commence lorsqu’il en fait une loi valable pour toutes les mathématiques. Quelqu’un aux qualifications bien plus impressionnantes peut commettre une erreur semblable dès lors qu’il cesse de voir les limites de ses modèles habituels.
Ce qui m’intéresse, c’est ce qu’une personne affirme et la manière dont elle le justifie. Où sont les faits, où sont les hypothèses ? Dans quelles conditions sa conclusion cesse-t-elle de tenir ? Voilà des questions qui permettent d’examiner réellement les erreurs, plutôt que d’essayer de les deviner à partir de la biographie de son interlocuteur.
Dans l’échange sur Hacker News qui ouvrait cet article, le commentateur n’expliquait toujours pas, dans sa réponse, ce qui clochait précisément dans la proposition biotechnologique. Il s’est contenté de citer un effet psychologique.
Quant à savoir si la proposition elle-même tenait la route, cette réponse ne nous l’apprend pas.
Tout ce que nous avons appris, c’est qu’on proposait à son auteur une place dans le dictionnaire, juste à côté de deux psychologues.
Références
- Hacker News. Discussion où un participant accuse un autre de subir l’effet Dunning–Kruger, août 2026. Discussion.
- Kruger J, Dunning D. (1999). Unskilled and unaware of it: How difficulties in recognizing one’s own incompetence lead to inflated self-assessments. Journal of Personality and Social Psychology, 77(6), 1121–1134. DOI.
- Krueger J, Mueller RA. (2002). Unskilled, unaware, or both? The better-than-average heuristic and statistical regression predict errors in estimates of own performance. Journal of Personality and Social Psychology, 82(2), 180–188. PubMed.
- Nuhfer E et al. (2016). Random Number Simulations Reveal How Random Noise Affects the Measurements and Graphical Portrayals of Self-Assessed Competency. Numeracy, 9(1). DOI.
- Gignac GE, Zajenkowski M. (2020). The Dunning-Kruger effect is (mostly) a statistical artefact: Valid approaches to testing the hypothesis with individual differences data. Intelligence, 80, 101449. DOI.
- Fix B. (2022). The Dunning-Kruger Effect is Autocorrelation. Economics from the Top Down.
- Andersource. (2022). I can’t let go of “The Dunning-Kruger Effect is Autocorrelation”. Andersource.
- Jansen RA, Rafferty AN, Griffiths TL. (2021). A rational model of the Dunning–Kruger effect supports insensitivity to evidence in low performers. Nature Human Behaviour, 5, 756–763. DOI.
- McIntosh RD et al. (2022). Skill and self-knowledge: Empirical refutation of the dual-burden account of the Dunning–Kruger effect. Royal Society Open Science, 9, 191727. DOI.
- The Null Institute. (2026). Dunning–Kruger Reanalysis: The Scale, the Baseline, and the Error Curve. Note de recherche.
- Moore DA, Healy PJ. (2008). The Trouble with Overconfidence. Psychological Review, 115(2), 502–517. DOI.
- JCVI. (7 avril 2021). Statement on use of the AstraZeneca COVID-19 vaccine. GOV.UK.