争论到没话可说时,还有个省事的办法:说对方有“邓宁–克鲁格效应”。意思是,他对问题一知半解,却连自己有多无知都不知道。他反驳得越自信,诊断似乎就越坐实。想辩解?任何反驳都能被当作又一条症状。
这招有个很有科学味道的名字,可它与真正的研究之间,关系并不那么简单。心理学家确实发现,在某些测验中,成绩较差的人往往更容易高估自己相对于他人的表现。研究者为此提出了心理学解释,也得到了一些实验结果的支持。后来人们发现,类似的图形也可能由其他原因造成,包括测量方法本身的特点。
不过,这些研究并不能让我们仅凭一个人在争论中的自信程度,就判断他到底懂不懂。
2026年8月,Hacker News上有人讨论一项颇为激进的生物技术提案。一名评论者回复提案作者,说他的名字应该写进词典,放在“邓宁–克鲁格效应”旁边[1]。这条回复既没有分析提案,也没有给出反对理由。似乎只要搬出两位心理学家的姓氏,事情就算说清楚了。
“愚蠢之巅”从哪儿来的?
你大概见过那张曲线图:一个人刚接触某个领域,自信心就一路冲上山顶。人们把这座山叫作“愚蠢之巅”(Mount Stupid)。接着是“绝望之谷”,最后再沿着“开悟之坡”缓缓爬升。
这图真好用。遇到哪个讨厌的争论对手,几乎都能在图上给他安排一个位置。通常还是靠近山顶的那个。
可问题是,贾斯廷·克鲁格(Justin Kruger)和戴维·邓宁(David Dunning)1999年的论文里,根本没有这张图[2]。作者也没有研究同一个人随着学习深入,自信心如何起伏。他们让不同的参与者完成幽默、语法和逻辑任务,再请他们估计自己相对于其他参与者的能力。
第一项实验中,成绩处于末尾四分之一的参与者,实际排名大约在第12百分位,却把自己估计在第58百分位左右。百分位表示一个人在群体中的相对位置:位于第20百分位,意味着大约20%的参与者得分比你低。
成绩更好的参与者,对自己的评价也更高,只是自评的增幅远小于实际成绩的增幅。研究并没有发现新手必然经历一个自信心爆棚的“山顶”。
克鲁格和邓宁的解释是:完成一项任务和发现自己犯了什么错,部分依赖同一套能力。一个刚学下棋的人,可能看不出自己再过三步就会被将死。他以为局面不错,不一定是因为傲慢,也可能只是还没有足够的知识识别危险。
其中一项实验里,研究者向参与者教授逻辑推理。接受训练后,他们的自我评估变得更准确。这确实是支持原假设机制的一条重要证据。所以,把1999年的研究简化成那张原本就不存在的“愚蠢之巅”曲线,同样不公平。
后来,其他研究者开始检验这条曲线是否还有更朴素的解释,比如测量方法自身造成的偏差。
学过一门学科,不等于真正理解它
曲线之争背后,还有一个更大的问题。即使掌握了测验成绩和参与者的自我评价,研究者也未必能确定一个人为什么会出错。可我们有时只看见网上一句底气十足的评论,就急着判断陌生人是否称职。
懂一个领域,和知道自己的知识在哪里止步,并不是同一回事。
还记得学校里那条老规矩吗?负数不能开平方根。
学生把规则背熟,顺利通过测验,得了个好成绩。现在,他觉得自己都可以给别人讲这条规则了。但如果一位数学教授告诉他,方程x² = −1其实有解,他可能立刻反驳:学校明明不是这么教的!
关键在于,两个人都可能是对的,只是所谈的数系不同。在实数范围内,确实无解;在复数范围内,则有两个解:i和−i,其中i² = −1。
教授知道,课堂上的那条规则只适用于实数。数系一旦扩展,原先不存在的解就出现了。
学生却可能把规则记得一字不差,没意识到它只适用于特定的数系。于是,正确的知识也能带出错误的结论。
顺便说一句,这个例子倒很贴合邓宁和克鲁格最初的假设:一个人可能既缺乏正确解题所需的知识,也缺乏识别自己错误所需的知识。这就是所谓能力不足的“双重负担”。它也不只发生在学生身上:专家也可能越过自己知识的边界,却毫无察觉。单凭一个心理学标签解释不了问题,得指出推理究竟在哪一步出了错。
在有关专业能力的争论中,我一直对这种区别很感兴趣。一个人学过专业知识、记熟定义、通过考试,拿到文凭和执业资格。按既定标准,他是合格的。但他有没有能力反过来检查这些标准,发现隐藏的前提,跳出自己熟悉的模型?
专业资质当然是信任专家的理由:背后有训练、实践和资格要求。但它并不保证专家说的每句话都正确。医生可能误诊,数学家可能忽略了错误的前提,研究者也可能高估自己的数据究竟能证明什么。
要判断一项具体主张是否成立,最终还得看证据和论证,而不是作者的履历。
下图把某个领域的知识储备,和独立检验推理的能力区分开来。
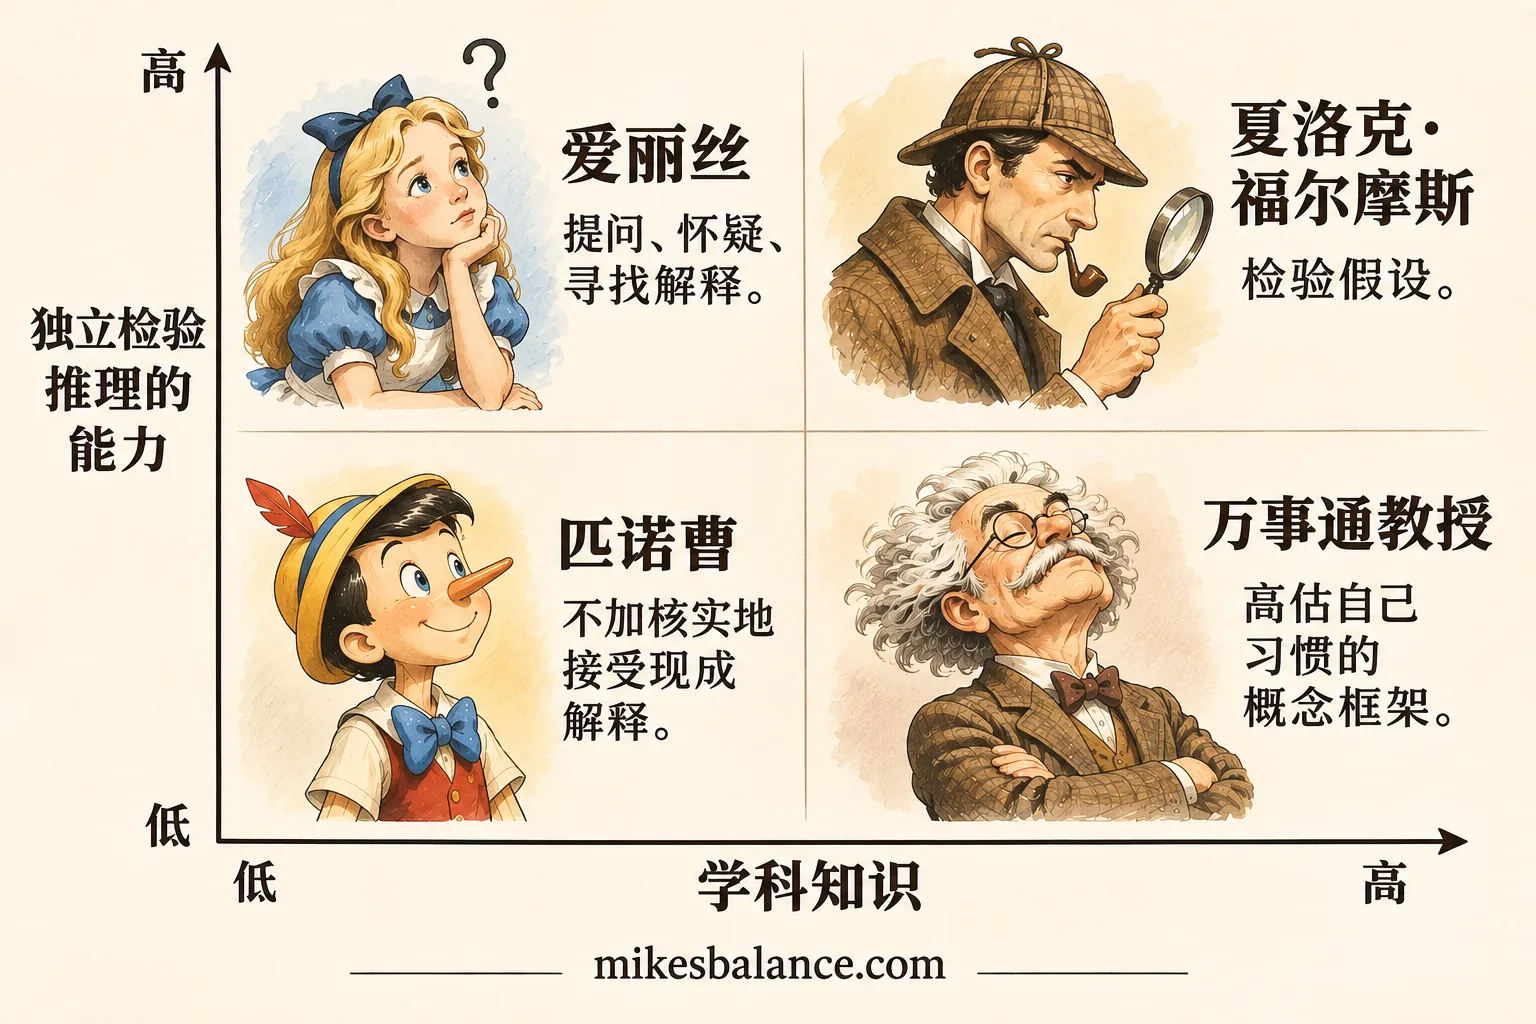
实际工作中,两种能力都少不了。知识让我们不必把别人已经验证过的东西重新摸索一遍;独立思考则帮助我们发现条件变了,或者熟悉的解释漏掉了关键环节。
一个没有相关学历的人提出异议,可能真的点出了专家的错误,也可能一碰到早已确立的事实就站不住脚。到底是哪一种,要检验的是异议本身。
自信程度无法告诉我们谁理解得更深。数学教授可能对复数的存在深信不疑,而且有充分理由。学生却可能同样自信地否认复数存在,只因为他以为学校教的规则适用于所有数学。
统计方法是怎样“画出”过度自信的?
假设两个人准备程度完全相同,平均都能答对70%的题。第一个人碰巧遇到一组不顺手的题,只得了60%;第二个人运气较好,拿到80%。两人都认为自己的水平是70%。谁高估了自己?其实谁都没有。但如果只拿这一次考试的分数来比较,第一个人似乎“高估”了10个百分点,第二个人则似乎“低估”了同样的10个百分点。
现在根据考试成绩把参与者分组。排名靠后的那组,会有更多碰巧做得不顺的人;排名靠前的,则有更多这次运气不错的人。那条熟悉的曲线就出现了:成绩差的人仿佛高估自己,成绩好的人仿佛低估自己。但在这个例子里,每个人对自身真实准备程度的估计都是准确的。
还有一道纯算术陷阱。“自我评估误差”通常等于自评分减去考试分数,然后再把这个差值与同一次考试分数比较。如果自评分不变,考试分数每增加10分,算出来的“误差”就自动减少10分。因为同一个考试分数被放进了比较式的两边。
这并不是说邓宁–克鲁格效应纯属虚构。问题在于:光看曲线的形状,判断不了它为什么会出现。约阿希姆·克鲁格(Joachim Krueger)和罗斯·穆勒(Ross Mueller)曾指出这个问题[3]。Nuhfer及其同事[4]、Gignac与Zajenkowski[5]则研究了随机噪声和测量方法的作用。
这里还有个有趣的细节:1999年论文的合作者贾斯廷·克鲁格(Justin Kruger),和2002年发表批评文章的约阿希姆·克鲁格(Joachim Krueger),是两个人。不然还真容易以为,克鲁格过了三年突然改变主意,亲自推翻了自己的研究。
布莱尔·菲克斯(Blair Fix)甚至用随机变量也画出了类似的曲线[6]。但他的模型预先假定,自我评价与实际表现相互独立。这是有用的数学检验,不是真实人群的画像;批评者也指出了这一点[7]。与此同时,Jansen及其同事找到了一些证据,表明成绩较差的参与者确实不太善于利用有关自身错误的信息[8]。
曲线确实存在。问题是,其中有多少来自心理机制,有多少来自测量方法本身?要回答这个问题,需要其他数据,而不是揣测参与者的性格。
同一场测验,两种大不相同的自我评价
“高估自己”到底是什么意思?是把自己答对的题数估多了,还是误判了自己在别人当中的排名?听起来相近,其实是两种不同的测量。
在 McIntosh 及其同事2022年的一项研究中,参与者先做矩阵推理题,然后自己估计答对了多少题,以及自己相对于其他学生的排名[9]。我们在 The Null Institute 独立复核了151名参与者的公开数据[10]。下面是预备测验成绩处于末尾四分之一的38人的结果:
| 评估项目 | 参与者自估 | 实际结果 |
|---|---|---|
| 答对题目的比例 | 76.0% | 76.1% |
| 在他人中的排名(百分位) | 51.2 | 19.8 |
第一行,自我估计与实际结果几乎完全一致。第二行却差了31.4 个百分位点。也就是说,同一批人平均而言相当清楚自己做对了多少题,却明显高估了自己在其他人当中的位置。
不过,这种“估得准”只体现在平均值上。38人中,22人高估了答对题数,14人低估,2人估计得完全准确。平均绝对误差为7.7个百分点:方向相反的误差抵消了一部分。
比较还有一个重要限制:参与者估计的是自己在爱丁堡大学学生中的位置,而我们计算的实际百分位来自这项研究的样本。自我评分的刻度也有些特殊:自我评价量表的零点对应50%的正确率,也就是随机猜测时的预期水平。我们的复核考虑了这个刻度,却无法知道每一位参与者究竟如何理解它[9]、[10]。
看整个样本,参与者平均甚至低估了自己的成绩7.64个百分点。但预备测验表现与自我评估误差之间,仍然呈负相关。成绩最高的四分之一,平均正确率已接近97%:往上高估的空间几乎没有,往下低估的空间却很大。
知道自己答对了多少题,与知道自己在别人当中排第几,是两回事。一个人可能准确估计自己的绝对成绩,却严重看错自己在群体中的位置。绝对自我评价与相对自我评价的区别,研究界早已知道[11]。我们的工作只是独立复核了一组具体数据,并没有发现新的心理学效应。详细表格、研究方法和代码都收录在The Null Institute的研究札记中。
专家也会修改建议
COVID-19疫情期间,知道什么、理解什么,以及实际该怎么做之间的区别,表现得格外明显。
评估疫苗安全性、感染风险和每项措施的必要性,需要不同的数据。但专业建议有时被当作现成答案,外行似乎只能照单全收。一旦有人提出疑问,人们可能不去检查问题本身,而是把疑问归咎于提问者“不懂行”。
阿斯利康(AstraZeneca)疫苗的经历,正说明这样做有什么问题。
大规模接种开始后,陆续出现了少见的病例报告:血栓形成同时伴有血小板数量下降。2021年4月7日,英国疫苗接种与免疫联合委员会(JCVI)建议:如果有其他疫苗可用,应向没有额外风险因素的30岁以下成年人提供替代疫苗[12]。
这次建议调整,依据的是有关严重不良反应的新数据,以及对这一特定人群接种收益与风险的重新权衡。
这类事情让我反感的,不是专家修改建议。面对新证据,专家本来就应该调整判断。更糟的是,有人把专业资质当成拒绝回答问题的挡箭牌。
没有医学背景的人提出的担忧,可能有道理,也可能完全错误。该怎么判断?还是得根据现有证据,认真分析他的具体问题。称他“不专业”,或者搬出邓宁和克鲁格的名字,并不算回答了问题。
究竟谁才算真正懂行?
说到这里,“专业能力”这个词本身反倒开始碍事了:讨论悄悄从某个具体错误,变成对整个人的评判。
克鲁格和邓宁研究的是参与者完成特定任务的表现,与他们如何认识自己能力之间的关系。这些研究不能让我们凭一条自信满满的评论,就判断一个人对某个领域理解有多深。更不能据此把任何与专业人士意见不同的情况,都当作某种心理缺陷的表现。
连他们1999年的数据都能说明这一点。第二项实验的逻辑测验中,成绩最低四分之一的参与者平均位于第12百分位,最高四分之一平均位于第86百分位。然而,两组对自己排名的估计却几乎一样:分别为第62和第68百分位[2]。实际表现相差74个百分位点,自我估计只差6个。当然,对相对排名的估计不等于对某项具体主张的信心,群体平均值也不能代表每一个人。但这些数字已经足以说明:不能仅凭一个人对自己评价很高,就反过来断定他能力低。
同样,一纸文凭也不能直接证明某项具体主张正确。它说明持有人接受过一定程度的训练,有时是很严格的训练,但不能代替对主张本身的核验。
回到那个学习平方根的学生。他记住的规则,在实数范围内是对的。错就错在,他把这条规则当成适用于所有数学的规律。一个履历耀眼得多的专家,也可能犯类似错误,只要他忘记检查自己熟悉的模型到底适用于哪里。
我关心的,是一个人究竟说了什么,又凭什么这样说。推理中的事实在哪里?假设在哪里?结论在哪些条件下会失效?有了这些问题,我们才能认真讨论论证哪里出了错,而不用凭对方的履历来猜。
再回到文章开头那场Hacker News争论。那名评论者在自己的回复中,始终没有解释生物技术提案究竟哪里有错。他只是甩出了一个心理学效应的名字。
至于提案本身到底靠不靠谱,单看他的回复,我们无从得知。
我们唯一知道的是:有人建议把提案作者的名字写进词典,挨着两位心理学家。
参考文献
- Hacker News. 2026年8月,一位参与者以“邓宁–克鲁格效应”指责另一位参与者的讨论。 讨论原文.
- Kruger J, Dunning D. (1999). Unskilled and unaware of it: How difficulties in recognizing one’s own incompetence lead to inflated self-assessments. Journal of Personality and Social Psychology, 77(6), 1121–1134. DOI.
- Krueger J, Mueller RA. (2002). Unskilled, unaware, or both? The better-than-average heuristic and statistical regression predict errors in estimates of own performance. Journal of Personality and Social Psychology, 82(2), 180–188. PubMed.
- Nuhfer E et al. (2016). Random Number Simulations Reveal How Random Noise Affects the Measurements and Graphical Portrayals of Self-Assessed Competency. Numeracy, 9(1). DOI.
- Gignac GE, Zajenkowski M. (2020). The Dunning-Kruger effect is (mostly) a statistical artefact: Valid approaches to testing the hypothesis with individual differences data. Intelligence, 80, 101449. DOI.
- Fix B. (2022). The Dunning-Kruger Effect is Autocorrelation. Economics from the Top Down.
- Andersource. (2022). I can’t let go of “The Dunning-Kruger Effect is Autocorrelation”. Andersource.
- Jansen RA, Rafferty AN, Griffiths TL. (2021). A rational model of the Dunning–Kruger effect supports insensitivity to evidence in low performers. Nature Human Behaviour, 5, 756–763. DOI.
- McIntosh RD et al. (2022). Skill and self-knowledge: Empirical refutation of the dual-burden account of the Dunning–Kruger effect. Royal Society Open Science, 9, 191727. DOI.
- The Null Institute. (2026). Dunning–Kruger Reanalysis: The Scale, the Baseline, and the Error Curve. 研究札记.
- Moore DA, Healy PJ. (2008). The Trouble with Overconfidence. Psychological Review, 115(2), 502–517. DOI.
- JCVI. (2021年4月7日). Statement on use of the AstraZeneca COVID-19 vaccine. GOV.UK.